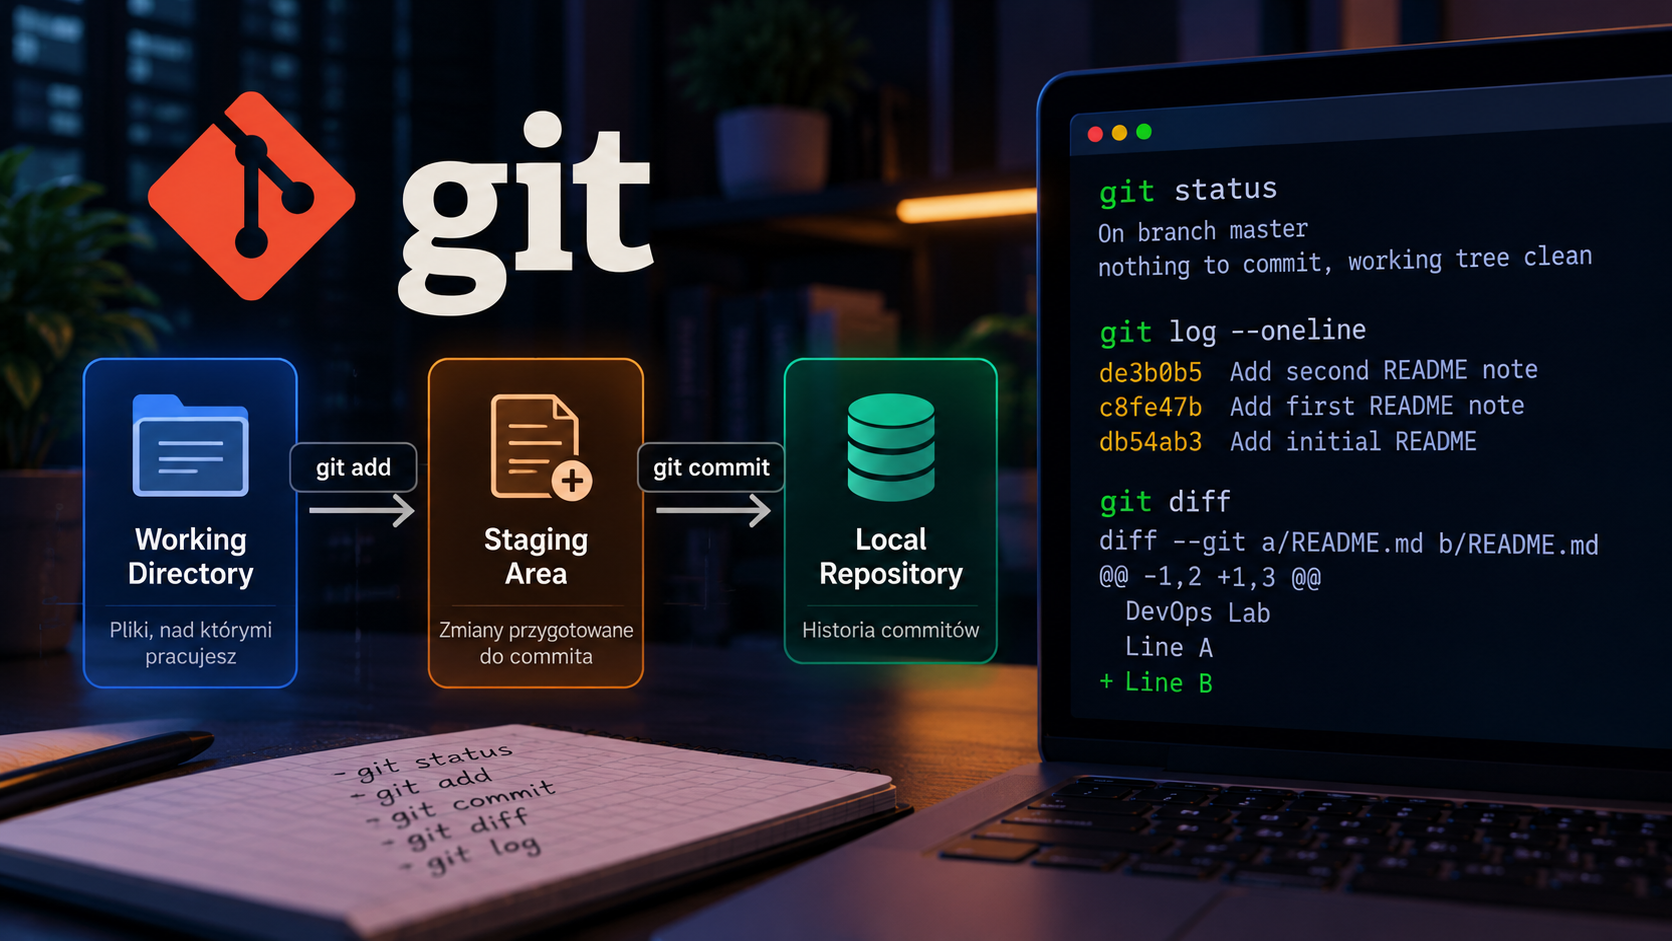
Przy pierwszym kontakcie z Gitem szybko pojawiają się pytania: czym różni się git add od git commit, dlaczego nie wszystkie zmiany trafiają do commita i co właściwie oznacza HEAD? W tym artykule przedstawię Ci podstawy gita, które pomogą Ci zrozumieć sposób wersjonowania plików. Przyjrzymy się działaniu Working Directory i Staging Area, prześledzimy proces zapisywania zmian i nauczymy się analizować historię commitów. Ta wiedza przyda Ci się zarówno podczas pracy nad kodem, jak i przy wersjonowaniu skryptów czy konfiguracji w DevOps.
Czym jest GIT
Ucząc się IT na pewno nie raz spotkałeś się z pojęciem kontroli wersji. Git bo to on jest najbardziej znanym systemem wersjonowania dosłownie zdominował świat. Setki firm i programistów korzystają z niego aby śledzić zmiany, współpracować przy projektach oraz analizować problemy z wcześniejszych wersji kodu. W oficjalnej dokumentacji Gita możemy przeczytać:
System kontroli wersji śledzi wszystkie zmiany dokonywane na pliku (lub plikach) i umożliwia przywołanie dowolnej wcześniejszej wersji.Brzmi logicznie prawda? Git to taki turbo przycisk zapisu, który nazywa się commitem. Podczas tworzenia commita tworzysz coś w stylu migawki wszystkich plików znajdujących się w folderze, w którym zainicjowałeś gita – znanym również jako repozytorium. Ta migawka zapisuje wszystko w aktualnym stanie , a do tego konkretnego commita możesz uzyskać dostęp później, jeśli coś zepsujesz.
Dlaczego warto uczyć się gita?
W tym momencie możesz zacząć się zastanawiać, skoro git zapisuje wersje danego projektu to po co mam go używać skoro mogę zapisywać kopie swojej pracy na Google Drive lub Dropbox. To troche pytanie w stylu dlaczego chirurg nie używa noża zamiast skalpela. Oczywiście, nóż może wykonać wiele zadań, ale w przypadku chirurga potrzebujesz bardziej precyzyjnego narzędzia.
Git jest właśnie takim skalpelem dla programisty. W chmurze po zapisaniu plików nie masz aż takiej kontroli nad historią zmian w nich. Musiałbyś pamiętać, jakie zmiany wprowadziłeś osobiście w danym pliku np w Kwietniu i Lipcu, a co jeśli tych plików w danym projekcie jest kilkaset i każdy ma po kilkaset linii kodu? Natomiast w git wszystkie zmiany jakie wprowadzasz są przechowywane wraz z informacją co się zmieniło od ostatniej zmiany. Za pomocą jednego polecenia dokładnie wiesz, które pliki i wiersze zostały zmienione.
Więcej informacji na temat gita, możesz znaleźć w darmowej książce.
Jak Git zarządza zmianami?
Na początek warto zrozumieć trzy obszary, z którymi pracujemy podczas korzystania z Gita:
    Working Directory
            |
            | git add
            v
       Staging Area
            |
            | git commit
            v
     Local Repository
Working directory
To katalog roboczy zawierający pliki projektu, nad którymi aktualnie pracujesz. To tutaj tworzysz nowe pliki, edytujesz kod, zmieniasz konfigurację lub usuwasz niepotrzebne elementy w projekcie.
Staging Area
Przechowuje stan plików przygotowanych do następnego commita. Aktualizujemy go poleceniem:
git addStaging Area daje kontrolę nad tym, które zmiany chcemy zapisać w historii. Możesz przykładowo zmodyfikować pięć plików, ale przygotować do commita tylko dwa z nich. Pozostałe z nich zostaną w katalogu roboczym.
Co jest niezwykle ważne, staging area przechowuje konkretną zawartość plików z momentu ich dodania poleceniem git add. Jeżeli później ponownie zostanie zmodyfikowana ich zawartość nie zostaną automatycznie zaktualizowane w staging area. Nie przejmuj się jeśli na ten moment nie rozumiesz, pokaże to później na przykładzie.
Local Repository
Przechowuje historie commitów i aktualny stan projektu. W momencie gdy wykonujemy:
git commitGit tworzy nowy commit na podstawie stanu plików dodanych do staging area.
Commit reprezentuje snapshot projektu, czyli zapisany stan śledzonych plików w określonym momencie historii.
Cały mechanizm sprowadza się do dwóch operacji:
git addprzygotowuje zawartość plików do zapisu.git commitzapisuje przygotowany stan projektu w historii repozytorium.
Rozdzielenie tych operacji pozwala świadomie decydować, co powinno znaleźć się w danym commicie.
Tworzenie pierwszego repozytorium
Do ćwiczeń wykorzystamy katalog devops-lab, który utworzymy na maszynie wirtualnej z Debianem.
Najpierw sprawdźmy, czy Git jest zainstalowany:
git --versionJeśli nie jest, możesz go zainstalować w debianie poleceniem:
apt install gitNastępnie utwórzmy katalog na potrzeby laba i przejdźmy do niego:
mkdir devops-lab
cd devops-lab
Aby zacząć korzystać z Gita, najpierw musisz zainicjować repozytorium w folderze, który Git będzie śledził w celu kontroli wersji. Będąc w katalogu devops-lab uruchom następujące polecenie:
git initTo polecenie tworzy ukryty podfolder .git, który zawiera wszystkie dane śledzenia i metadane Gita dla repozytorium. Możemy go zobaczyć za pomocą polecenia:
ls -laPo zainicjowaniu repozytorium możesz rozpocząć śledzenie plików za pomocą podstawowych poleceń Gita.
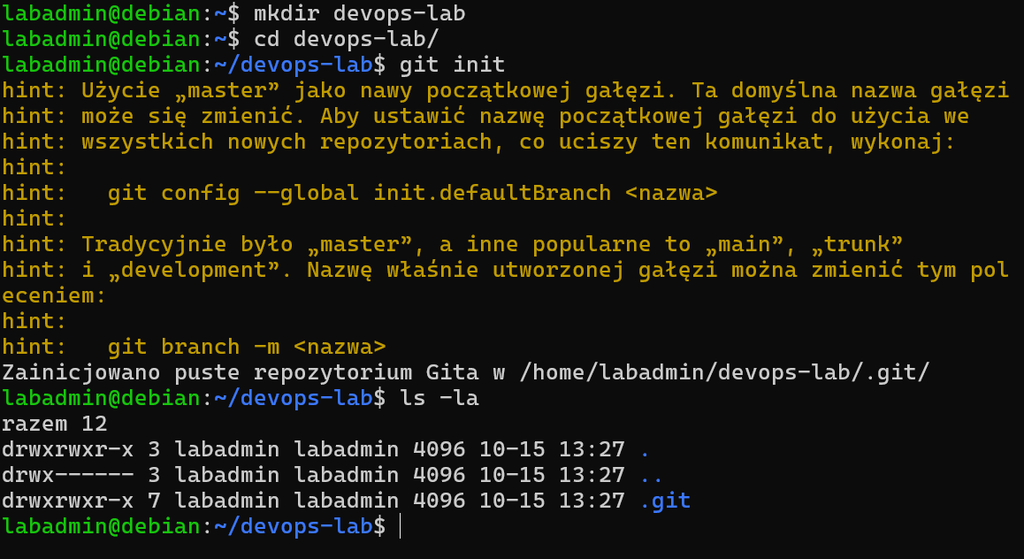
Warto wiedzieć, że usunięcie katalogu .git nie usuwa zwykłych plików projektu. Tracimy jednak lokalne dane repozytorium, w tym jego historię i konfigurację.
Konfiguracja użytkownika
Zanim utworzymy pierwszy commit, skonfigurujmy dane autora. Każde zatwierdzenie w Git ma przypisanego autora, z podanym imieniem i nazwiskiem oraz adresem e-mail. Aby ustawić te dane, użyj poniższych poleceń.
Możemy ustawić je dla bieżącego repozytorium:
git config user.name "Jan Kowalski"
git config user.email "jan@example.com"
Jeśli chcemy używać tych samych danych domyślnie we wszystkich repozytoriach, dodajemy opcję --global:
git config --global user.name "Jan Kowalski"
git config --global user.email "jan@example.com"
Aktualne wartości globalne sprawdzimy poleceniami:
git config --global user.name
git config --global user.email
Konfiguracja lokalna repozytorium ma pierwszeństwo przed globalną.
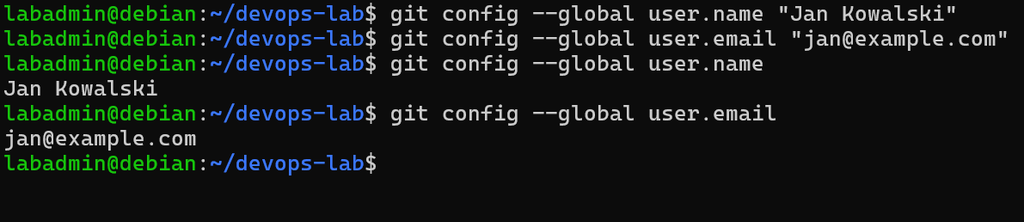
Podane dane będą zapisywane w metadanych commitów. Nie są one hasłem ani mechanizmem uwierzytelniania do GitHuba.
Pierwszy plik i git status
Jedną z najczęsciej używanych komend Gita jest:
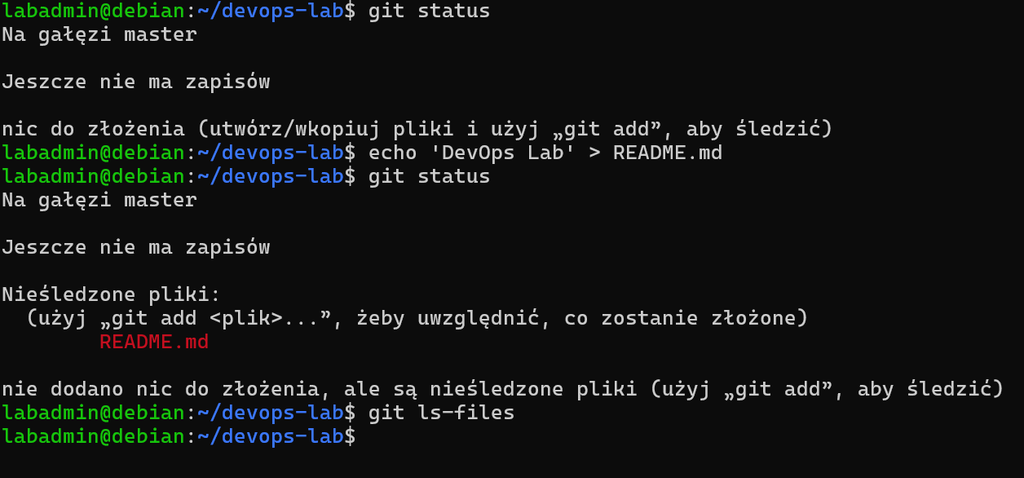
git statusPokazuje ona stan repozytorium: pliki nieśledzone, zmiany przygotowane do commita oraz modyfikacje, które pozostają w katalogu roboczym. Na ten moment zobaczysz komunikat, że na gałęzi master nie ma jeszcze żadnych zapisów.
Utwórzmy więc pierwszy plik:
echo 'DevOps Lab' > README.mdSprawdźmy stan repozytorium:
git statusGit pokaże README.md w sekcji:
Nieśledzone pliki:
    README.md
Plik istnieje w katalogu projektu, ale Git jeszcze go nie śledzi.
Możemy to sprawdzić:
git ls-filesPolecenie nie wyświetli README.md, ponieważ plik nie został jeszcze dodany do staging area.
Dodawanie plików przez git add
Aby dodać pliki do staging area, które mają zostać zatwierdzone należy skorzystać z polecenia git add.
git add README.mdNastępnie:
git statusTeraz zobaczymy, że plik trafił do staging area:
Zmiany do złożenia:
    nowy plik: README.md
Po ponownym uruchomieniu polecenia git ls-files zobaczysz, że git już śledzi plik, a jego aktualna zawartość jest przygotowana do zapisu:
git ls-files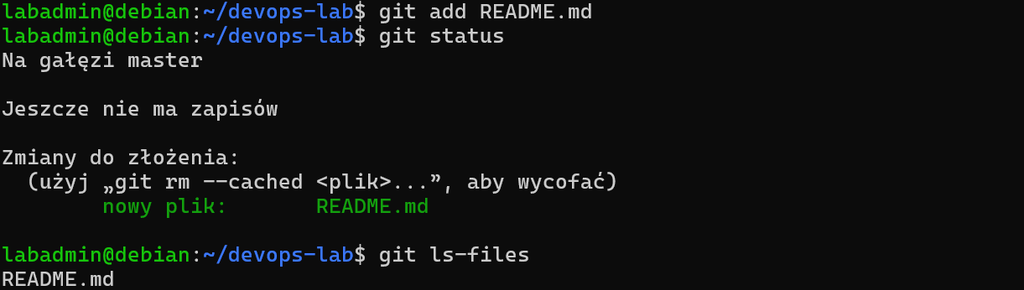
Możemy też dodawać kilka plików jednocześnie:
git add file1 file2Możemy również przygotować wszystkie zmiany z bieżącego katalogu i jego podkatalogów:
git add .Ta komenda jest wygodna, ale wymaga ostrożności, uruchomiona z katalogu głównego repozytorium może dodać nowe pliki, modyfikacje oraz usunięcia, których nie planowaliśmy uwzględniać w jednym commicie. Domyślnie pomija pliki ignorowane przez Gita. Dlatego przed zapisem zmian warto sprawdzić, co znajduje się w staging area.
Tworzenie pierwszego commita
Przed wykonaniem commita sprawdźmy przygotowane zmiany:
git diff --stagedPonieważ repozytorium nie ma jeszcze żadnego commita, Git porówna przygotowaną zawartość z pustym stanem początkowym. W wyniku zobaczymy fragment:
+# DevOps LabZnak + oznacza dodaną linię.
Po dodaniu plików do staging area możesz zatwierdzić go za pomocą polecenia git commit. Zatwierdzenie to zapis zmian wprowadzonych w repozytorium. Aby zatwierdzić pliki z staging area z czytelnym komunikatem, użyj następującego polecenia:
git commit -m "Add initial README"Git zapisze stan przygotowany w staging area jako pierwszy commit na gałęzi master.
Sprawdźmy status:
git statusPowinniśmy zobaczyć:
nic do złożenia, drzewo robocze czyste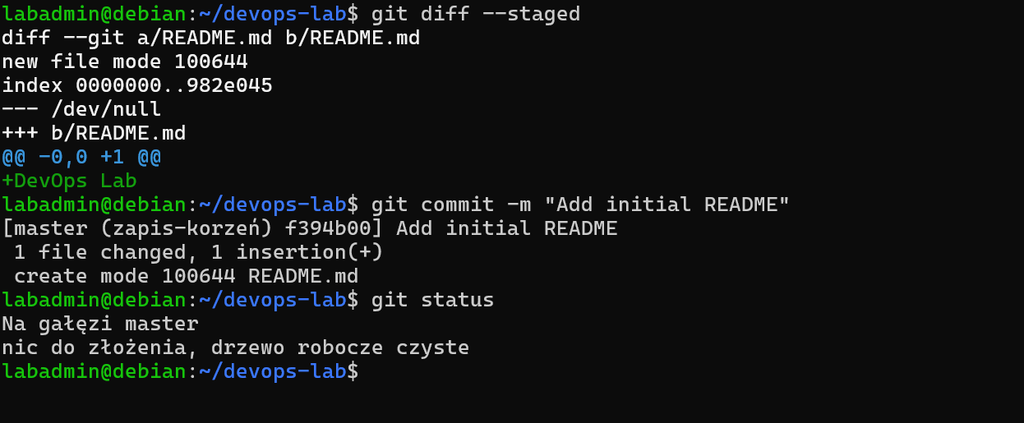
Oznacza to, że nie mamy oczekujących zmian do zapisania. Zawartość śledzonych plików w katalogu roboczym i staging area odpowiada aktualnemu commitowi. Od tego momentu każda zmiana wprowadzona w dowolnym pliku w folderze będzie rejestrowana i porównywana z tą początkową migawką.
Co naprawdę dzieje się po git add?
Różnicę pomiędzy working directory a staging area najlepiej zobaczyć na konkretnym przykładzie.
Mamy plik README.md o zawartości:
# DevOps LabDodajmy kolejną linię:
echo 'Line A' >> README.mdNastępnie przygotujmy plik do commita:
git add README.mdW staging area znajduje się teraz wersja:
# DevOps Lab
Line A
Dopiszmy jeszcze jedną linię:
echo 'Line B' >> README.mdTym razem nie wykonujemy ponownie git add.
W katalogu roboczym mamy:
# DevOps Lab
Line A
Line B
Staging area nadal przechowuje wcześniejszą wersję:
# DevOps Lab
Line A
W uproszczeniu wygląda to tak:
Working Directory
-----------------
# DevOps Lab
Line A
Line B

        |
        | Ostatnie git add
        v

Staging Area
------------
# DevOps Lab
Line A

        |
        | git commit
        v

Local Repository
----------------
Commit zapisze Line A,
ale nie zapisze Line B
Jeżeli teraz wykonamy:
git commit -m "Update README"commit zapisze:
Line Aale nie:
Line BDlaczego się tak dzieje? Ponieważ git add aktualizuje staging area na podstawie zawartości pliku w chwili wykonania polecenia git add. Późniejsza edycja pozostaje zmianą w working directory, dopóki ponownie jej nie przygotujemy poleceniem git add.
Porównywanie zmian za pomocą polecenia git diff
Git udostępnia dwa podstawowe sposoby sprawdzania różnic podczas pracy nad plikami.
git diff
Poniższe polecenie porównuje stan śledzonych plików w working directory ze staging area:
git diffW naszym przykładzie zobaczymy:
 # DevOps Lab
 Line A
+Line B
Git pokazuje Line B, ponieważ tej zmiany nie ma jeszcze w staging area. Line A występuje w obu wersjach pliku, więc nie jest oznaczona jako nowa zmiana w tym porównaniu.
git diff –staged
Teraz uruchommy:
git diff --stagedTo polecenie porównuje staging area z ostatnim commitem, wskazywanym przez HEAD. Wynik będzie wyglądał tak:
 # DevOps Lab
+Line A
Widzimy wyłącznie Line A, ponieważ tylko ta zmiana została przygotowana do commita.
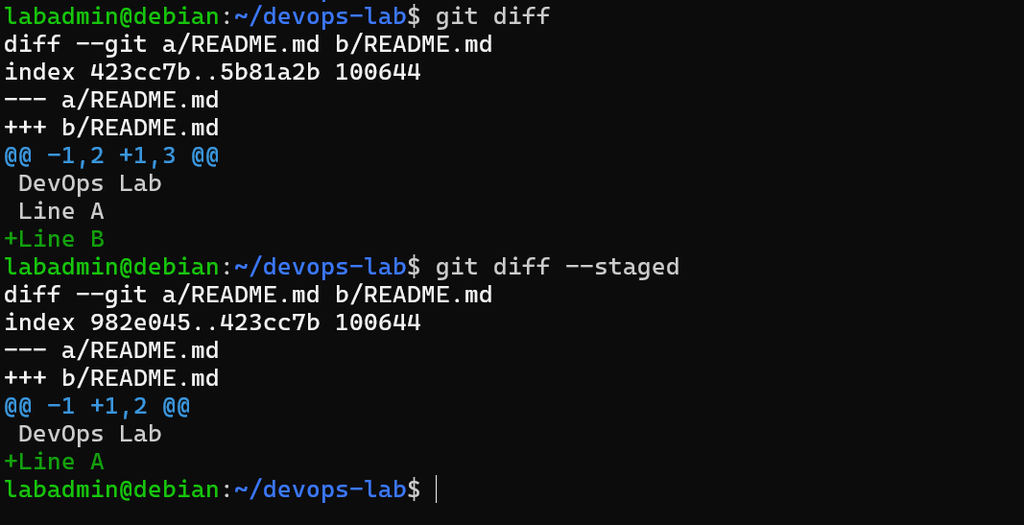
Różnice między komendami można przedstawić następująco:
       HEAD
  (ostatni commit)
          |
          | git diff --staged
          v
     Staging Area
          |
          | git diff
          v
   Working Directory
W codziennej pracy git diff --staged przydaje się szczególnie przed wykonaniem commita. Pozwala zobaczyć, jakie różnice względem poprzedniego commita zostały przygotowane do zapisu.
Zapisujemy przygotowaną zmianę
Wykonajmy:
git commit -m "Add first README note"Commit zapisze wersję pliku zawierającą Line A.
Możemy to sprawdzić:
git show HEAD:README.mdWynik:
# DevOps Lab
Line A
Z kolei:
cat README.mdpokaże:
# DevOps Lab
Line A
Line B
Ostatnia linia nadal znajduje się w katalogu roboczym. Git jej nie usunął. Po prostu nie uwzględnił jej w commicie.
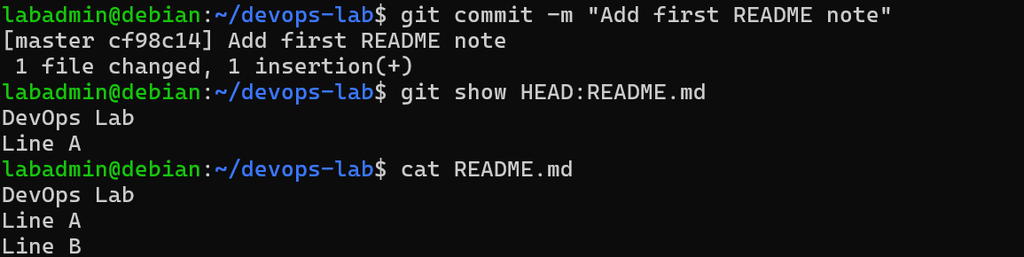
Zapiszmy ją w osobnym commicie:
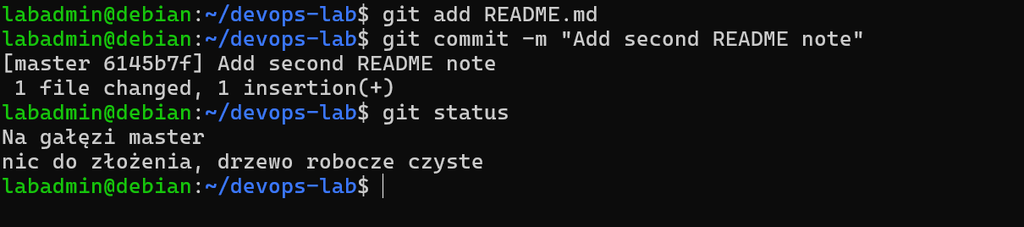
git add README.md
git commit -m "Add second README note"
Po wykonaniu:
git statusPowinniśmy zobaczyć czyste drzewo robocze. W ten sposób utworzyliśmy trzy commity, z których każdy reprezentuje inny stan projektu.
Jeden commit, jedna logiczna zmiana
Przy tworzeniu commitów warto trzymać się zasady, że każdy z nich powinien mieć konkretny cel.
Add system information script
Add application configuration
Document installation process
Powyższe commity są łatwiejsze do przeanalizowania niż nic nie znaczący komentarz “changes”. Nie chodzi o to, żeby każdy commit zawierał jak najmniej linii kodu. Jeśli wprowadzenie jednej funkcjonalności wymaga zmiany kilku plików, mogą one znaleźć się w jednym commicie. Ważne, żeby zmiany były ze sobą logicznie powiązane.
Przydaje się to podczas code review, szukania regresji czy wycofywania błędnych zmian.
Przeglądanie historii przez git log
Do wyświetlenia historii commitów służy polecenie:
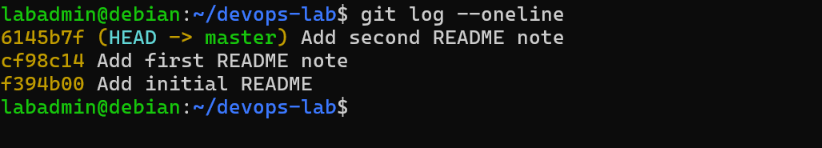
git logPolecenie to pokazuje szczegółowe informacje, m.in. pełne identyfikatory, autorów, daty i wiadomości commitów. Na co dzień wygodniejsza bywa wersja skrócona:
git log --onelineW naszym repozytorium zobaczymy historię podobną do tej:
de3b0b5 Add second README note
c8fe47b Add first README note
db54ab3 Add initial README
Identyfikatory są przykładowe. W Twoim repozytorium będą inne.
Każda linia reprezentuje jeden commit. Po lewej znajduje się jego skrócony identyfikator, a po prawej wiadomość opisująca zmianę.
Graficzne przedstawienie historii
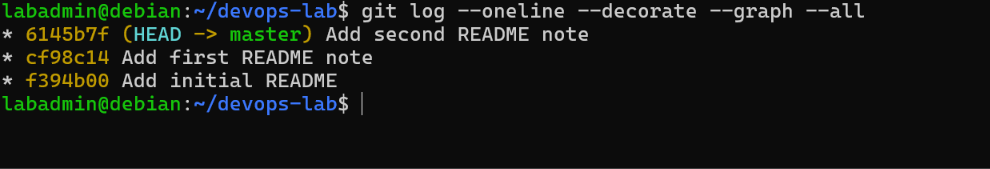
Warto poznać jeszcze jedno polecenie:
git log --oneline --decorate --graph --allDla naszej liniowej historii wynik będzie wyglądał mniej więcej tak:
* de3b0b5 (HEAD -> main) Add second README note
* c8fe47b Add first README note
* db54ab3 Add initial README
Na razie graf jest prosty. Gdy zaczniemy tworzyć branche i wykonywać merge, pojawią się rozgałęzienia. Wtedy ta komenda staje się szczególnie przydatna.
Hash commita
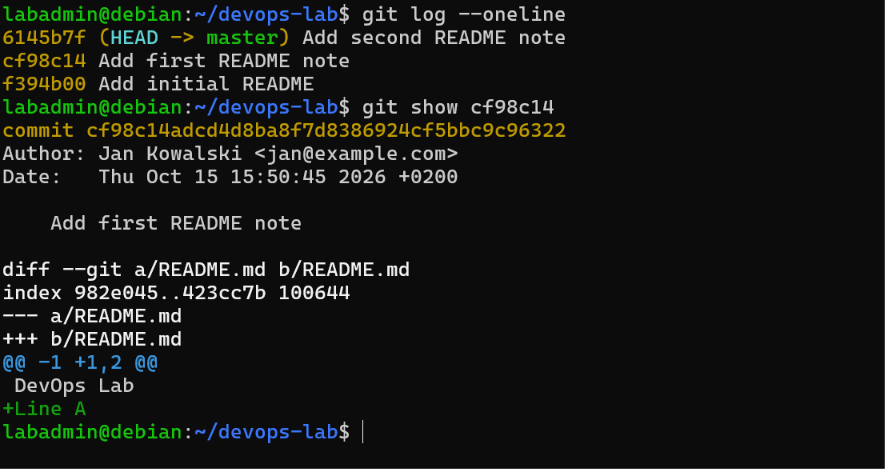
Każdy commit ma swój identyfikator służący do odróżnienia go od innych. Pełny 40-znakowy identyfikator aktualnego commita wyświetlimy poleceniem:
git rev-parse HEADHash pozwala odwołać się do konkretnego commita. Możemy go wykorzystać np. w poleceniu:
git show IDW praktyce należy podać identyfikator istniejący w naszym repozytorium. Przydaje się to podczas analizowania błędów, porównywania wersji oraz przeglądania starszych zmian.
HEAD i branch master
Podczas przeglądania historii wielokrotnie spotkamy nazwę HEAD.
W typowej sytuacji HEAD wskazuje aktualnie wybraną gałąź, a ta wskazuje konkretny commit.
HEAD
 |
 v
master
 |
 v
Commit C
Jesteśmy na branchu master, który wskazuje na commit C.
Co się dzieje po utworzeniu nowego commita?
Załóżmy, że mamy historię:
A <--- B <--- C
              ^
             master
              ^
             HEAD
Wprowadzamy zmianę i tworzymy commit D.
Historia będzie wyglądała tak:
A <--- B <--- C <--- D
                    ^
                   master
                    ^
                   HEAD
Git przesuwa wskaźnik master na nowy commit. HEAD nadal wskazuje na master.
Poruszanie się po historii: HEAD~1, HEAD~2
Git umożliwia odwoływanie się do wcześniejszych commitów bez podawania ich hashy.
Weźmy historię:
A <--- B <--- C <--- D
                    ^
                   HEAD
Możemy odwołać się do commitów w następujący sposób:
HEAD    = D
HEAD~1  = C
HEAD~2  = B
HEAD~3  = A
Przykładowo aby wyświetlić zawartość poprzedniego commita możemy skorzystać z poniższego polecenia:
git show HEAD~1Z kolei jeśli chcemy wyświetlić commit oddalony o dwa kroki wstecz możemy skorzystać z poniższego:
git show HEAD~2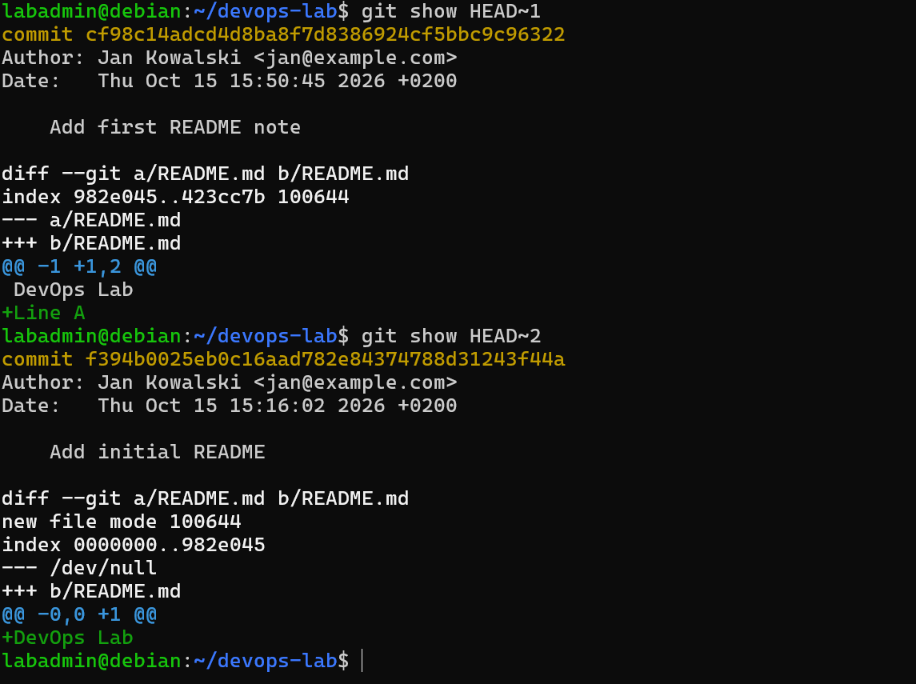
Porównywanie commitów przez git diff
Git pozwala porównywać nie tylko working directory i staging area, ale również dowolne dwa punkty historii.
git diff <starszy-commit> <nowszy-commit>Załóżmy, że historia wygląda tak:
A <--- B <--- C <--- D
      ^               ^
   starszy          nowszy
Wykonując:
git diff B Dotrzymamy różnicę pomiędzy stanem projektu w commicie B a stanem w commicie D.
Porównanie HEAD~2 z HEAD
W naszym repozytorium utworzyliśmy trzy commity:
A <--- B <--- C
^             ^
HEAD~2       HEAD
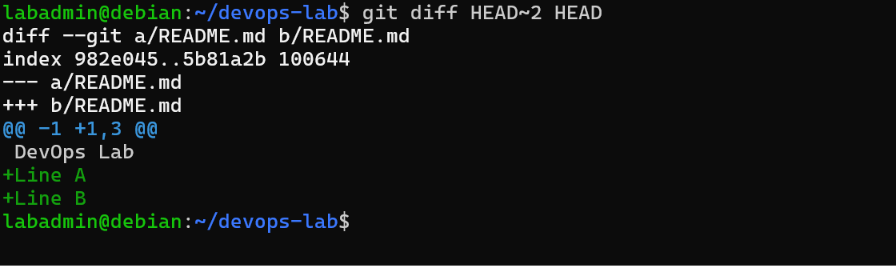
Commit A zawierał tylko nagłówek README. W B dodaliśmy Line A, a w C dodaliśmy Line B.
Uruchommy:
git diff HEAD~2 HEADWynik będzie zawierał:
 # DevOps Lab
+Line A
+Line B
Git porównał stan z pierwszego commita ze stanem aktualnym.
Dlaczego historia Gita jest przydatna w DevOps?
W DevOps Git często służy do wersjonowania znacznie większej liczby elementów niż sam kod aplikacji. W repozytoriach mogą znajdować się skrypty automatyzujące zadania, konfiguracje usług, Dockerfile, pliki Terraform czy definicje pipeline’ów CI/CD. Załóżmy, że aplikacja działała poprawnie przez kilka wdrożeń, ale po ostatnim deploymencie zaczęła zgłaszać błędy.
Historia wygląda tak:
A --- B --- C --- D --- E
            |           |
         Wersja       Wersja
         działająca   z problemem
Wiemy, że commit C odpowiadał działającej wersji, a po wdrożeniu E wystąpił problem.
Możemy porównać oba stany:
git diff <commit-C> <commit-E>Git pokaże zmiany we wszystkich śledzonych plikach między wskazanymi commitami. Mogą to być na przykład:
Dockerfile
docker-compose.yml
.github/workflows/deploy.yml
terraform/main.tf
config/application.yml
W ten sposób możemy zauważyć zmodyfikowaną wartość konfiguracyjną, zmianę nazwy zmiennej środowiskowej czy poprawkę w procesie wdrożenia.
Praktyczny workflow pracy z Gitem
Na podstawie omówionych przykładów możemy ułożyć prosty schemat codziennej pracy.
Najpierw sprawdzamy stan repozytorium:
git statusNastępnie wprowadzamy potrzebne zmiany w plikach i sprawdzamy ich zakres:
git diffGdy mamy już gotowe zmiany, przygotowujemy wybrane pliki:
git add README.mdPrzed zapisaniem commita sprawdzamy staging area:
git diff --stagedJeśli wszystko się zgadza, tworzymy commit:
git commit -m "Update project documentation"Na koniec kontrolujemy stan repozytorium i historię:
git status
git log --oneline
Schemat wygląda następująco:
Sprawdzenie statusu
        |
        v
   Edycja plików
        |
        v
     git diff
        |
        v
      git add
        |
        v
  git diff --staged
        |
        v
     git commit
        |
        v
     git status
Z czasem część tych operacji staje się nawykiem. Szczególnie przydatne jest sprawdzanie zawartości staging area przed każdym commitem.
Ściągawka z komend
| Komenda | Do czego służy |
|---|---|
git init | Tworzy repozytorium |
git status | Pokazuje stan repozytorium |
git status --short | Wyświetla skrócony status plików |
git ls-files | Wyświetla pliki śledzone w staging area |
git add <plik> | Przygotowuje wskazany plik do commita |
git add . | Przygotowuje zmiany z bieżącego katalogu i podkatalogów |
git diff | Pokazuje zmiany nieprzygotowane do commita |
git diff --staged | Pokazuje zmiany znajdujące się w staging area |
git commit -m "message" | Tworzy commit z przygotowanego stanu |
git log | Wyświetla historię commitów |
git log --oneline | Pokazuje skróconą historię |
git log --oneline --decorate --graph --all | Wyświetla graficzną historię |
git rev-parse HEAD | Zwraca pełny identyfikator aktualnego commita |
git show HEAD | Pokazuje szczegóły aktualnego commita |
git show HEAD~1 | Pokazuje poprzedni commit wzdłuż pierwszego rodzica |
git diff HEAD~2 HEAD | Porównuje aktualny snapshot ze starszym |
git diff HASH1 HASH2 | Porównuje dwa wskazane stany projektu |
Następny krok: Znasz już podstawy działania Gita, wiesz, jak przygotowywać zmiany do commita i analizować historię repozytorium. W kolejnej lekcji połączymy lokalne repozytorium z GitHubem. Poznasz komendy clone, remote, push, fetch i pull oraz dowiesz się, jak przesyłać i pobierać zmiany ze zdalnego repozytorium.
Przejdź do następnej lekcji: Git i GitHub – zdalne repozytorium, gałęzie i merge →
